RAG Explicado: Como Dar Memória e Conhecimento aos LLMs
O problema que o RAG resolve
Modelos de linguagem são brilhantes, mas têm duas limitações: eles não conhecem seus documentos privados e podem "alucinar" (inventar respostas). O RAG (Retrieval-Augmented Generation) resolve os dois problemas.
A ideia é simples: antes de responder, a IA busca a informação relevante nos seus dados e usa esse contexto para gerar uma resposta precisa e fundamentada.
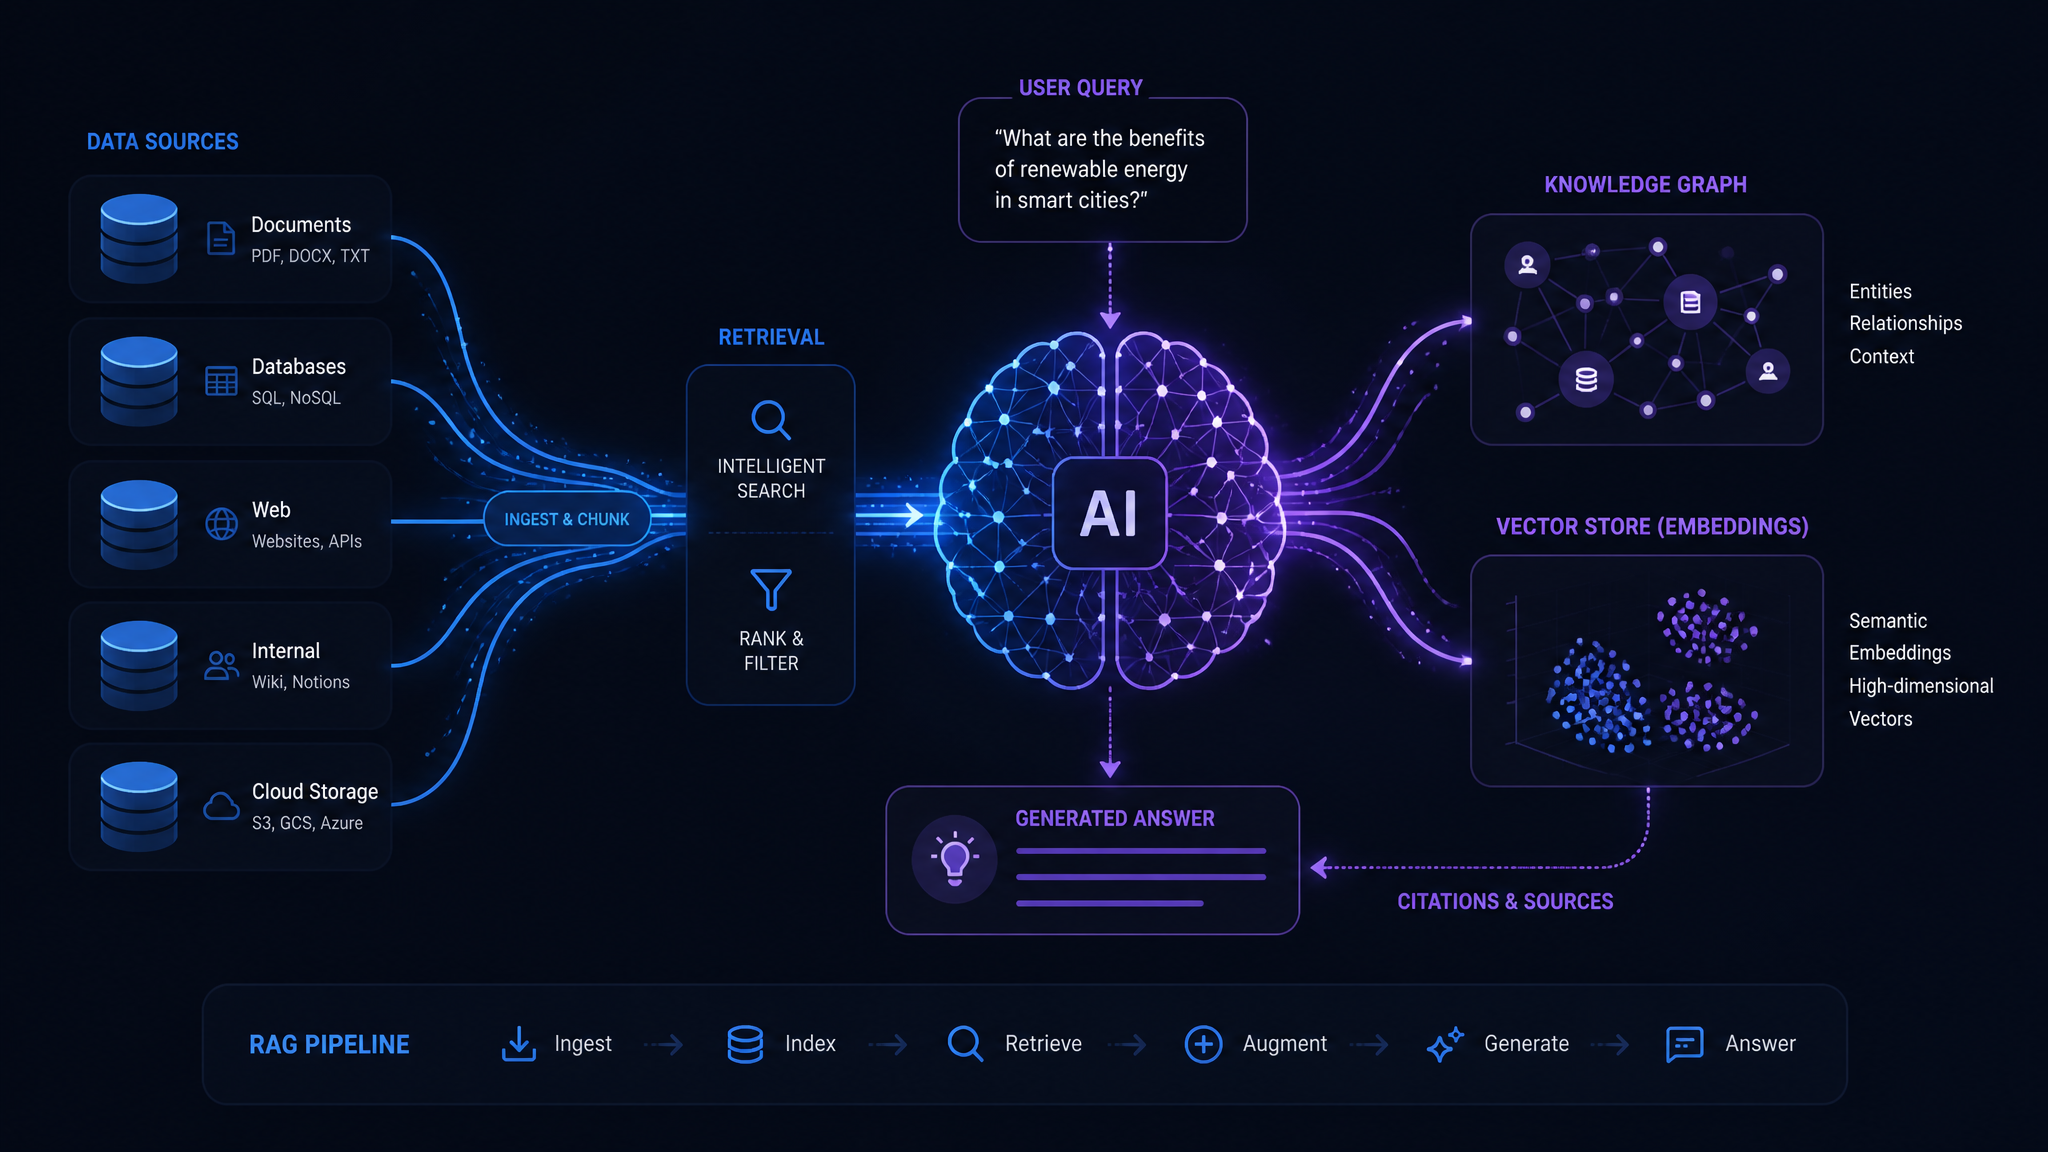
Como o RAG funciona, passo a passo
1. Indexação (preparação)
Seus documentos (PDFs, textos, páginas) são divididos em pedaços menores ("chunks") e convertidos em embeddings — representações numéricas do significado. Esses vetores são guardados em um banco de dados vetorial.
2. Recuperação (retrieval)
Quando o usuário faz uma pergunta, ela também vira um embedding. O sistema busca os chunks mais semanticamente parecidos com a pergunta.
3. Geração (generation)
Os trechos recuperados são enviados ao LLM junto com a pergunta, no estilo: "Com base nestes documentos, responda...". A IA responde usando apenas informação real.
Um exemplo prático
Imagine um chatbot de suporte que responde com base no manual da sua empresa:
# 1. Pergunta do usuário
pergunta = "Como faço para trocar meu plano?"

# 2. Busca os trechos relevantes no manual
trechos = banco_vetorial.buscar(pergunta, top_k=3)

# 3. Gera a resposta com contexto real
resposta = llm(f"Contexto: {trechos}\n\nPergunta: {pergunta}")
print(resposta)
O resultado? Uma resposta correta, baseada no seu conteúdo — sem invenções.
Onde o RAG é usado
- ▪Atendimento ao cliente com base na documentação da empresa.
- ▪Assistentes jurídicos que consultam leis e contratos.
- ▪Buscadores internos inteligentes para grandes bases de conhecimento.
- ▪Tutores que respondem com base em material de curso.
RAG vs Fine-tuning
Muita gente confunde. O RAG injeta conhecimento no momento da pergunta, sem retreinar o modelo — ideal para dados que mudam. O fine-tuning ajusta o comportamento do modelo — ideal para estilo e tarefas específicas. Na maioria dos casos profissionais, o RAG é o ponto de partida.
Domine na prática
RAG é uma das habilidades mais valorizadas hoje. Na IA Expert Academy, você aprende a construir sistemas RAG completos — do processamento de documentos ao banco vetorial e à geração de respostas — prontos para aplicar em projetos reais e produtos comerciais.
Pronto para dominar a IA de verdade?
Da Fase 0 (Python do zero) ao avançado, com projetos reais e tutor com IA.
Ver planos e matricular-se