Como funciona o treinamento de modelos de linguagem: O Guia Completo
Como funciona o treinamento de modelos de linguagem (LLMs)? Se você já usou o ChatGPT ou o Claude, provavelmente se perguntou como essas ferramentas conseguem responder perguntas, traduzir idiomas e até escrever códigos complexos com tanta naturalidade. O segredo não está em "mágica", mas sim em um processo rigoroso de processamento de dados e poder computacional.
Neste artigo, vamos desvendar os bastidores da criação de um LLM, desde a coleta massiva de dados até o refinamento final. Prepare-se para entender a arquitetura que está mudando o mundo.
A Base de Tudo: O Pré-treinamento
O treinamento de um modelo de linguagem começa com o que chamamos de pré-treinamento. Nesta fase, o modelo é exposto a uma quantidade colossal de texto da internet — livros, artigos, códigos de programação, fóruns e muito mais.
O objetivo principal aqui é simples, mas poderoso: o modelo deve aprender a prever a próxima palavra (ou "token") em uma sequência. Ao fazer isso trilhões de vezes, ele começa a entender padrões gramaticais, fatos sobre o mundo e até nuances de raciocínio.
Tokenização e Embeddings
Antes de "ler", o modelo transforma o texto em números. Cada palavra ou pedaço de palavra é convertido em um token. Em seguida, esses tokens são representados como vetores matemáticos chamados embeddings. Esses vetores permitem que o modelo entenda que a palavra "cachorro" está semanticamente próxima de "animal" ou "estimulante", mas longe de "computador".
A Arquitetura Transformer
A grande revolução dos LLMs modernos veio com o artigo "Attention Is All You Need" (2017), que apresentou o Transformer. Diferente das redes neurais antigas, o Transformer usa um mecanismo chamado Atenção (Attention).
A atenção permite que o modelo olhe para todas as palavras de uma frase simultaneamente e entenda quais são as mais relevantes para o contexto atual. Por exemplo, na frase "O banco estava fechado porque era feriado", o modelo usa o mecanismo de atenção para ligar a palavra "banco" ao contexto de "fechado" e "feriado", deduzindo que se trata de uma instituição financeira e não de um assento de praça.
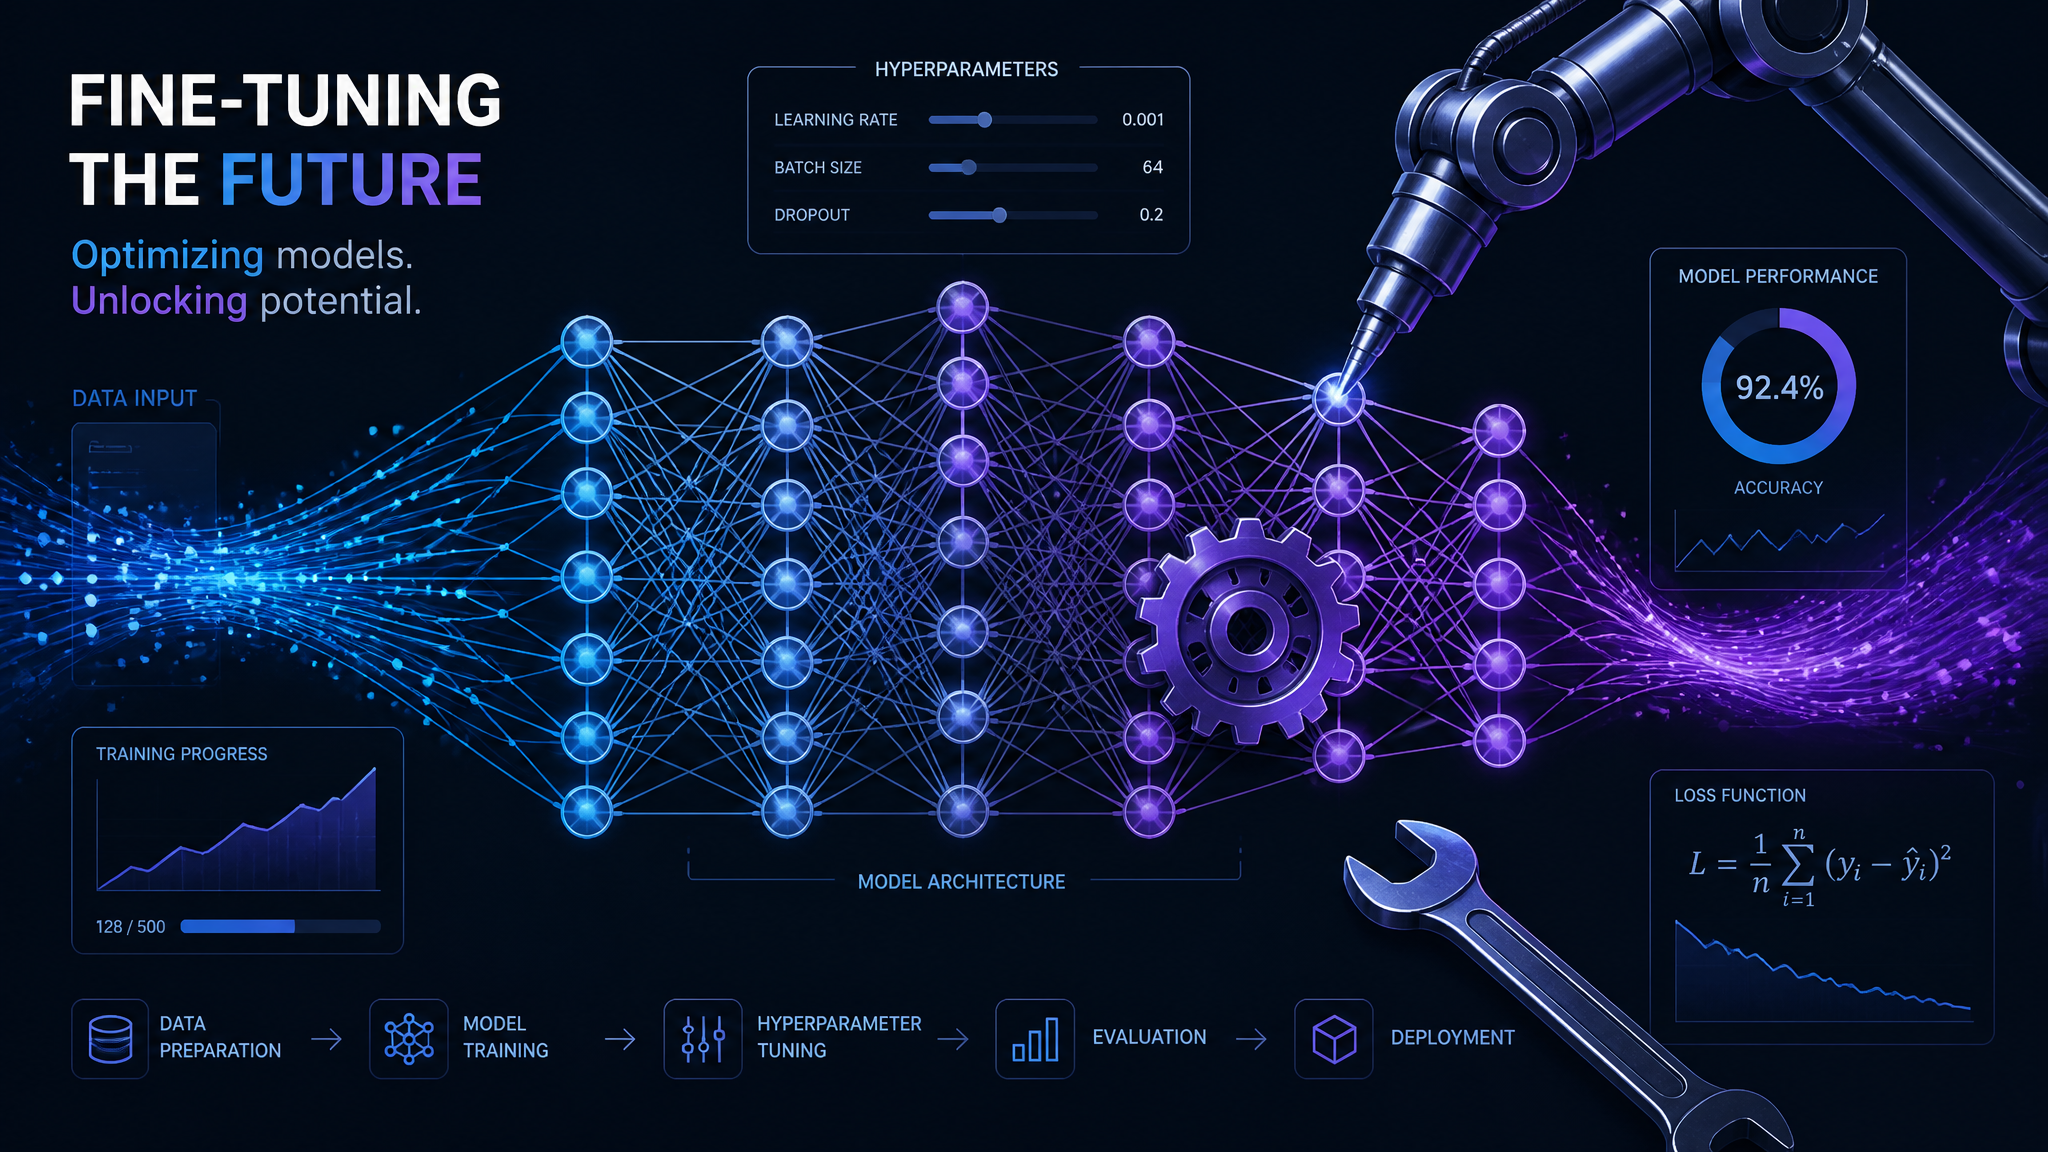
Refinamento: SFT e RLHF
Após o pré-treinamento, o modelo é uma enciclopédia gigante, mas ainda não sabe como interagir bem com humanos. Ele pode simplesmente continuar um texto de forma aleatória em vez de responder a uma pergunta. Para resolver isso, entramos na fase de refinamento.
Supervised Fine-Tuning (SFT)
Nesta etapa, humanos especialistas criam exemplos de "Pergunta e Resposta". O modelo é treinado especificamente nesses dados para aprender o formato de um assistente útil.
Reinforcement Learning from Human Feedback (RLHF)
Aqui é onde a "personalidade" e a segurança do modelo são moldadas. Humanos classificam diferentes respostas geradas pelo modelo, indicando qual é melhor, mais segura ou mais precisa. Um modelo de recompensa é treinado com esses dados e, em seguida, o LLM é otimizado para maximizar essa recompensa.
Exemplo Prático: Como a IA processa texto com Python
Embora não treinemos um modelo gigante em casa, podemos usar bibliotecas como a transformers da Hugging Face para ver a tokenização em ação. Veja este exemplo simples:
from transformers import AutoTokenizer

# Carregando o tokenizador de um modelo popular (ex: GPT-2)
tokenizer = AutoTokenizer.from_pretrained("gpt2")

texto = "Treinar modelos de IA é fascinante."
tokens = tokenizer.encode(texto)
tokens_decodificados = [tokenizer.decode([t]) for t in tokens]

print(f"Texto original: {texto}")
print(f"Tokens (IDs): {tokens}")
print(f"Tokens (Texto): {tokens_decodificados}")
Neste código, você consegue ver exatamente como a frase é quebrada em pequenas unidades que o modelo consegue processar matematicamente.
O Desafio da Computação
Treinar um LLM de ponta exige milhares de GPUs (como as H100 da NVIDIA) funcionando em paralelo por meses. O custo de eletricidade e hardware pode chegar a centenas de milhões de dólares. É por isso que, hoje, apenas grandes empresas e laboratórios de pesquisa dominam essa fronteira.
Conclusão: O Futuro é Agora
Entender como os modelos de linguagem são treinados nos tira da posição de meros usuários e nos coloca como conhecedores de uma ferramenta poderosa. Estamos saindo da era da busca por palavras-chave para a era da compreensão semântica profunda.
Se você quer ir além de apenas usar a IA e deseja aprender a construir soluções, automatizar processos e dominar as tecnologias que estão moldando o futuro, você está no lugar certo. A IA Expert Academy oferece trilhas completas para transformar você em um especialista capaz de navegar com maestria neste novo oceano tecnológico. O futuro não espera, e o seu treinamento começa hoje.
Pronto para dominar a IA de verdade?
Da Fase 0 (Python do zero) ao avançado, com projetos reais e tutor com IA.
Ver planos e matricular-se