O que é MLOps e por que toda empresa precisa em 2026
A Inteligência Artificial (IA) e o Machine Learning (ML) deixaram de ser meros experimentos em laboratórios de pesquisa para se tornarem o motor central de inovação nas empresas modernas. No entanto, muitas organizações ainda enfrentam um desafio crítico: como levar um modelo desenvolvido no Jupyter Notebook para um ambiente de produção escalável e confiável? A resposta para essa pergunta reside em um conceito fundamental chamado MLOps.
Neste artigo, vamos explorar o que é MLOps, por que ele se tornou indispensável para qualquer estratégia de dados e como você pode começar a aplicar seus princípios hoje mesmo.
O que é MLOps?
O termo MLOps é uma junção de Machine Learning e Operations (Operações). De forma simplificada, ele é para o Machine Learning o que o DevOps é para o desenvolvimento de software tradicional. O objetivo principal do MLOps é padronizar e automatizar o ciclo de vida dos modelos de ML, garantindo que o desenvolvimento, o deploy e o monitoramento ocorram de forma eficiente e sustentável.
Enquanto o desenvolvimento de software tradicional foca em código, o Machine Learning envolve três pilares: Código, Dados e Modelos. Se os dados mudam, o comportamento do software muda, mesmo que o código permaneça o mesmo. Essa característica única torna a gestão de modelos muito mais complexa do que a de aplicações convencionais.
A Diferença entre DevOps e MLOps
Embora o MLOps herde muitos princípios do DevOps (como Integração Contínua e Entrega Contínua - CI/CD), ele introduz necessidades específicas:
1.Treinamento Contínuo (CT): Modelos precisam ser retreinados periodicamente com novos dados para evitar a degradação da performance.
2.Versionamento de Dados: Além de versionar o código, é preciso saber exatamente qual conjunto de dados foi usado para treinar uma versão específica do modelo.
3.Monitoramento de Performance: Não basta monitorar se o servidor está no ar; é preciso monitorar se as predições do modelo continuam precisas (detecção de *data drift*).
Por que sua empresa precisa de MLOps?
Implementar MLOps não é apenas uma escolha técnica, mas uma decisão estratégica de negócios. Sem processos bem definidos, os modelos de IA tornam-se passivos técnicos caros e difíceis de manter.
1. Velocidade de Time-to-Market
Sem MLOps, o processo de deploy é manual, lento e propenso a erros. Com um pipeline automatizado, o tempo necessário para colocar um novo modelo em produção é reduzido drasticamente, permitindo que a empresa responda rápido às mudanças do mercado.
2. Confiabilidade e Reprodutibilidade
Você já passou pela situação de ter um modelo que funciona na máquina do cientista de dados, mas falha em produção? O MLOps garante que o ambiente de treinamento seja idêntico ao de produção, eliminando o clássico problema do "funciona na minha máquina".
3. Escalabilidade
Gerenciar um único modelo manualmente é possível. Gerenciar dezenas ou centenas de modelos em diferentes regiões e para diferentes clientes é impossível sem automação. O MLOps fornece a infraestrutura necessária para escalar operações de IA sem aumentar proporcionalmente a equipe.
Os Componentes de um Pipeline MLOps
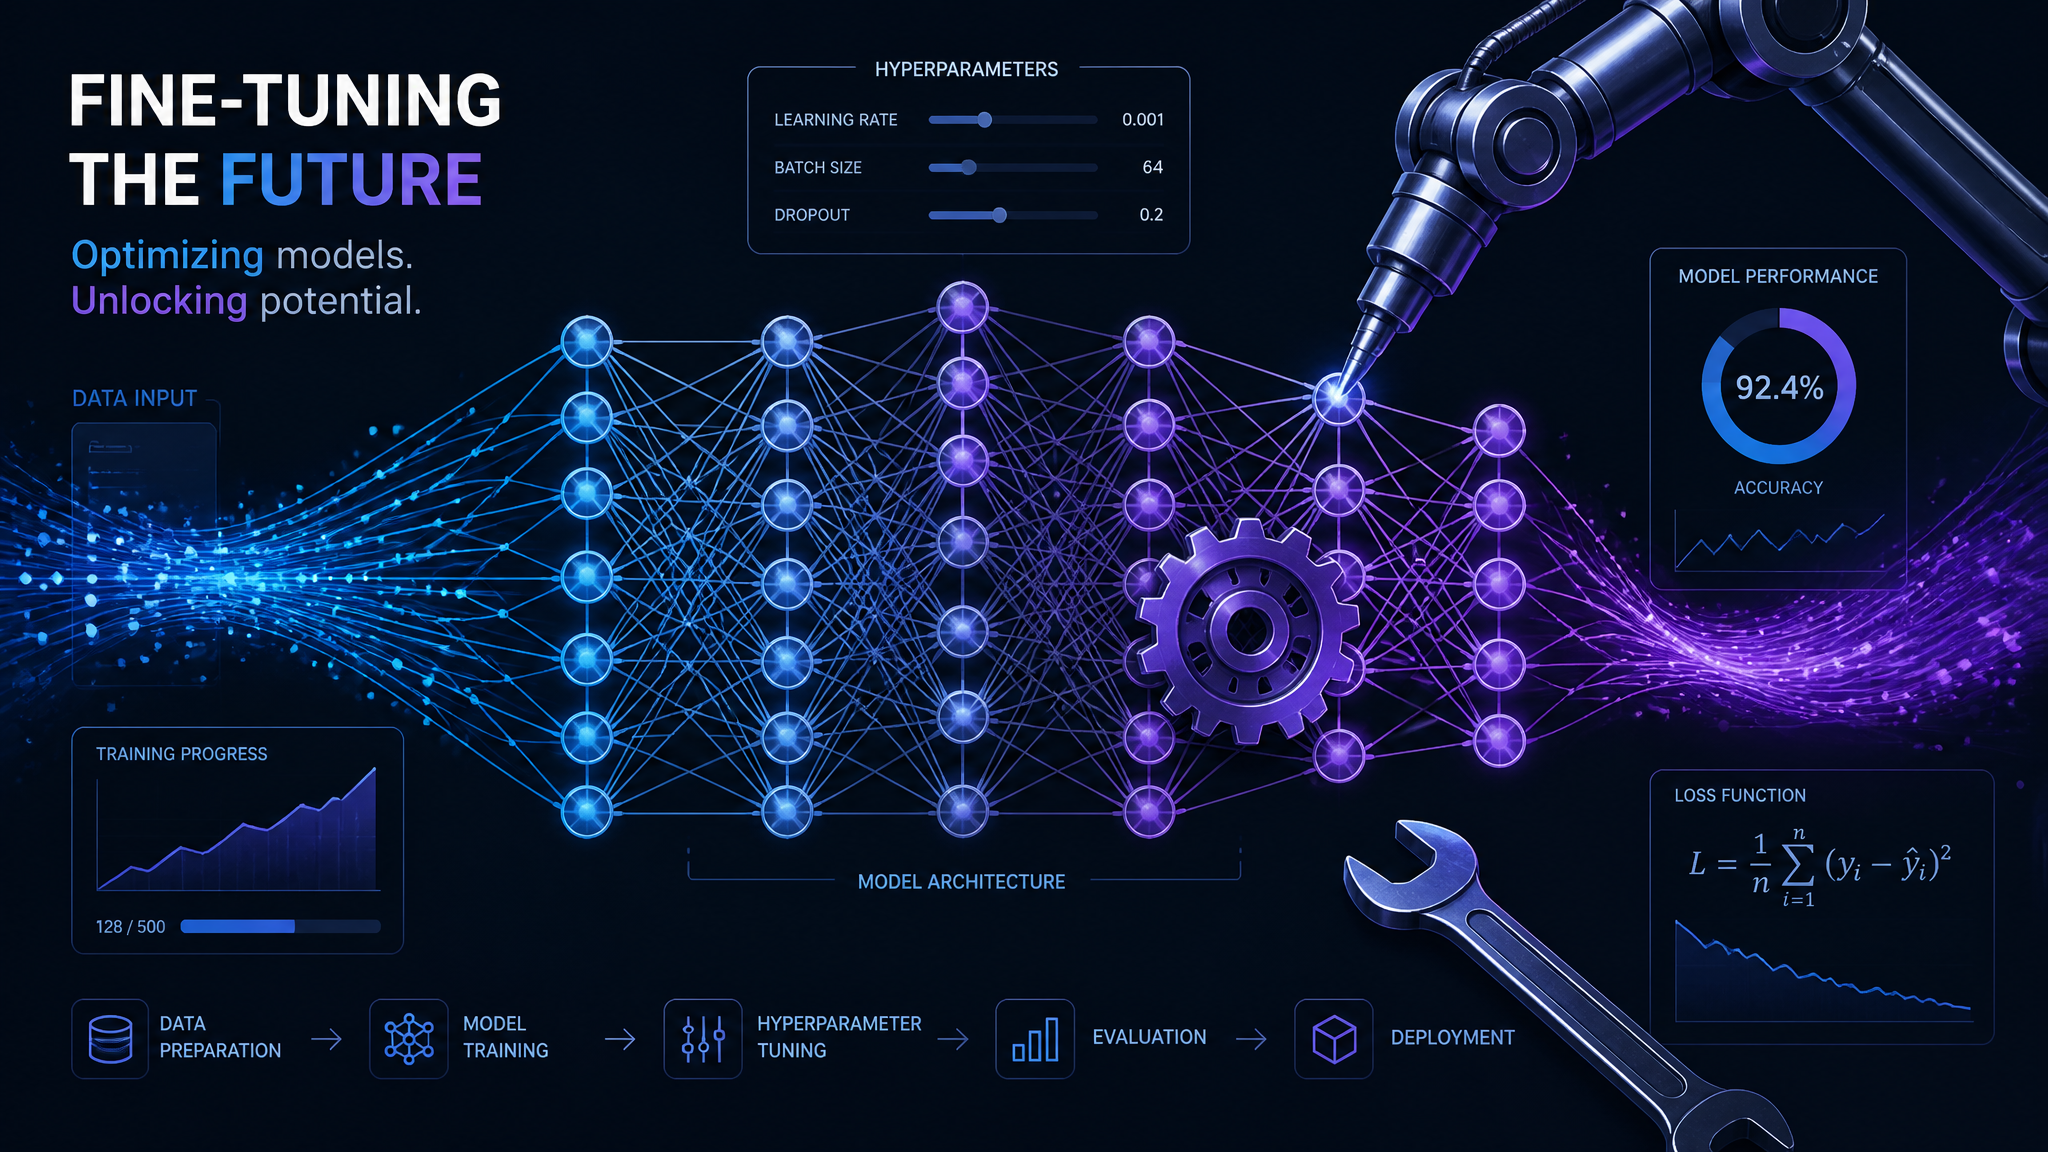
Um pipeline robusto de MLOps geralmente segue estas etapas:
1.Ingestão e Preparação de Dados: Automação da coleta e limpeza dos dados.
2.Treinamento e Validação: Execução de experimentos e escolha do melhor modelo com base em métricas pré-definidas.
3.Registro do Modelo: Armazenamento centralizado de modelos treinados e seus metadados.
4.Deploy: Publicação do modelo como API ou serviço em batch.
5.Monitoramento: Acompanhamento constante da saúde do modelo e dos dados.
Exemplo Prático em Python
Para ilustrar a automação, veja um exemplo simples de como poderíamos usar uma biblioteca como o MLflow para registrar um experimento:
import mlflow
import mlflow.sklearn
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.datasets import load_iris

# Iniciando um experimento no MLflow
mlflow.set_experiment("Classificacao_Iris")

with mlflow.start_run():
    # Carregando dados
    data = load_iris()
    X_train, X_test, y_train, y_test = train_test_split(data.data, data.target, test_size=0.2)

    # Parâmetros do modelo
    n_estimators = 100
    mlflow.log_param("n_estimators", n_estimators)

    # Treinando o modelo
    clf = RandomForestClassifier(n_estimators=n_estimators)
    clf.fit(X_train, y_train)

    # Avaliando
    predictions = clf.predict(X_test)
    acc = accuracy_score(y_test, predictions)
    mlflow.log_metric("accuracy", acc)

    # Salvando o modelo
    mlflow.sklearn.log_model(clf, "modelo_rf")
    print(f"Modelo treinado com acurácia: {acc}")
Neste exemplo, o MLflow captura automaticamente os parâmetros, as métricas e o próprio artefato do modelo, permitindo total rastreabilidade — um dos pilares do MLOps.
Desafios Comuns na Implementação
Embora os benefícios sejam claros, a jornada para o MLOps tem obstáculos. O principal deles é a cultura. Cientistas de dados, engenheiros de dados e equipes de operações precisam falar a mesma língua. Além disso, a escolha das ferramentas certas (como Kubeflow, SageMaker, TFX ou Azure ML) deve estar alinhada à infraestrutura já existente na empresa.
Conclusão
MLOps não é mais opcional para empresas que desejam extrair valor real da Inteligência Artificial. Ele é a ponte entre o potencial teórico dos dados e o impacto prático nos negócios. Ao adotar práticas de MLOps, sua organização garante que a IA seja escalável, segura e, acima de tudo, lucrativa.
Se você quer dominar as ferramentas e técnicas de MLOps, a IA Expert Academy oferece cursos práticos e imersivos que preparam você para os desafios reais do mercado. Comece hoje mesmo a construir o futuro da IA!
Pronto para dominar a IA de verdade?
Da Fase 0 (Python do zero) ao avançado, com projetos reais e tutor com IA.
Ver planos e matricular-se